In questa paginetta utilizziamo pero' uno stack leggermente diverso, Il componente Kacacitor di streaming dei dati non ci e' necessario e per la visualizzazione dei dati utilizzeremo Grafana che e' un altro software Open Source.
Quindi nel seguito utilizzeremo lo Stack TIG: Telegraf, InfluxDB, Grafana.
InfluxDB
InfluxDB e' il piu' noto Time Series Database (TSDB). Un TSDB consente di memorizzare e reperire in modo molto efficiente dati raccolti per serie temporali. Da questo punto di vista le statistiche prestazionali di un sistema operativo e dei database
InfluxDB e' un database NoSQL ed utilizza concetti differenti rispetto
agli altri database, relazionali o non.
I dati vengono raccolti in misure (measurement),
ogni evento e' un punto (point) che ha sempre un timestamp.
Possono essere raccolte ulteriori informazioni in campi (field)
o etichette (tag). I tag sono indicizzati e le ricerche su di loro
sono molto piu' efficienti ma sono solo di tipo stringa.
Per fare un parallelo con un DB relazionale le measurement sono tabelle,
i point sono righe, il timestamp e' sempre la chiave primaria, i field
sono le colonne ed i tag sono le colonne indicizzate.
Per interrogare i dati si utilizza l'InfluxQL, un query language di 4 generazione.
Naturalmente gli accessi per indice sono molto piu' efficienti
mentre una ricerca su un field richiede un FULL SCAN.
Le analogie con i relazionali pero' finiscono qui...
Non e' necessario creare le tabelle o definire le colonne:
quando vengono introdotti i dati vengono create automaticamente
tutte le strutture necessarie.
Non esistono join tra misure o altri oggetti
ed eventuali correlazioni vanno implementate applicativamente.
Non esistono operazioni CRUD almeno nel senso normale:
solo l'inserimento di point nelle measurement.
Non sono presenti transazioni: ogni punto viene inserito immediatamente,
in pratica l'unica operazione atomica e' l'INSERT.
Ulteriori funzionalita' di InfluxDB, fondamentali per le prestazioni, sono le CQ (continuous query) e le RP (retention policy). Le CQ consentono di aggregare i dati in modo effiente mentre le RP cancellano automaticamente i dati quando non sono piu' necessari.
Con la versione 2 di InfluxDB l'architettura si e' evoluta integrando
i diverse componenti in un unico eseguibile senza dipendenze dall'esterno
programmabile con il linguaggio di interrograzione e scripting Flux.
Altre novita' della 2.0 sono i bucket che riuniscono il concetto di database e periodo di ritenzione,
le organization che sono in pratica gruppi di utenti a cui abilitare le dashboard ed i bucket
ed i task che sono l'evoluzione delle continuous query.
Nel seguito parleremo di InfluxDB riferendoci ad entrambe le versioni perche'
sono entrambe utilizzabili senza sostanziali differenze.
Telegraf
Telegraf e' il componente di data collection dello stack InfluxDB ma e' puo' anche essere utilizzato anche separatamente.
Un grosso vantaggio di Telegraf e' la sua semplice configurazione
che prevede la compilazione di sezioni separate nel file di configurazione.
Sono disponibili oltre 150
Input Plugin
molto completi e costantemente aggiornati.
Ad esempio compilando la sezione [[inputs.postgresql]] del file /etc/telegraf/telegraf.conf verranno raccolte, con l'intervallo desiderato, le statistiche prestazionali dalle viste di sistema PostgreSQL pg_stat_database, pg_stat_bgwriter ed inserite in InfluxDB nella metrica "telegraf"."autogen"."postgresql". Ulteriori statistiche PostgreSQL possono essere raccolte con il plugin [[inputs.postgresql_extensible]]. Si tratta solo di un esempio... le statistiche raccolte per MySQL sono ancora piu' dettagliate!
I dati raccolti con gli input plugin vengono inviati sugli output plugin configurati.
Tra questi il piu' semplice e' [[outputs.influxdb]] perche' necessita solo dell'URL
di InfluxDB su cui inserire i dati.
I dati vengono inviati con il line protocol che Telegraf usa in modo nativo.
Naturalmente con [[outputs.influxdb_v2]] vanno indicati anche l'organization ed il bucket
come previsto nella v.2.
Data la semplicita' di configurazione telegraf e' molto utilizzato anche con output plugin differenti da InfluxDB.
Cenni sulle prestazioni
Una volta installato InfluxDB puo' essere utilizzato immediatamente. Ma perche' le prestazioni siano ottimali e' opportuno utilizzare delle best pratices.
InfluxDB e' uno schemaless database.
Si possono aggiungere nuove measurement, tag, and field in qualsiasi momento.
L'unico limite e' che non possono essere variati i data type
(eg. su un field utilizzato inizialmente come intero non e' possibile inserire una stringa).
Questo pero' non vuol dire che non sia opportuno progettare
la base dati raggruppando o meno i campi nelle stesse misure
e scegliendo opportunamente i tag di ricerca.
Oltre ad un corretto disegno della base dati, sono molto importanti le politiche di retention che definiscono la durata temporale dei dati.
Altra funzionalita' importante per le prestazioni e' la possibilita' di creare
CONTINUOUS QUERY, in pratica viste precalcolate mantenute aggiornate in modo continuo.
Vediamo qualche semplice esempio:
-- CREATE RETENTION POLICY retention_policy_name ON database_name DURATION duration REPLICATION n [SHARD DURATION duration] [DEFAULT]

> CREATE RETENTION POLICY "h4" ON "iot_db" DURATION 4h REPLICATION 1 DEFAULT
> CREATE RETENTION POLICY "y1" ON "iot_db" DURATION 52w REPLICATION 1
> CREATE CONTINUOUS QUERY "cq_1h" ON "iot_db" BEGIN
  SELECT mean("temp") AS "mean_temperature", sum("bytes") AS "sum_bytes"
  INTO "a_year"."data_h1"
  FROM "raw_data"
  GROUP BY time(60m)
END
Cenni sull'amministrazione
Una volta installato InfluxDB e' possibile utilizzarlo immediatamente!
Tuttavia per un'installazione di produzione e' consigliata un'adeguata
configurazione anche se molto semplice.
La configurazione si effettua nel file /etc/influxdb/influxdb.conf
che e' diviso in sezioni.
Per default InfluxDB v.1 non utilizza autenticazione. E' possibile configurarla con:
[http]
enabled = true
bind-address = ":8086"
auth-enabled = true
Le utenze vengono quindi definite in modo simile a quello usato nei DB relazionali:
Nella versione 1.x erano presenti due tipi di utenti (admin ed utenti normali) e sugli utenti normali venivano definiti semplicemente gli accessi in READ e WRITE (ALL entrambe) per i database. Tutto qui!
Dalla versione 2 la configurazione e' molto piu' flessibile, comprende anche l'accesso ad altri componenti (eg. dashboard) e puo' essere definita in modo gerarchico per organizzazione.
Versioni ed upgrade
Mantenersi aggiornati con le versioni e' sempre importante [NdE: serve a rimanere giovani e tutto e' piu' veloce :-] ...
naturalmente questo vale anche per InfluxDB!
La versione piu' recente di InfluxDB e' la 2.0 [NdA 2020-11]
che ha modifica in modo significativo l'architettura presentanto tutti
i componenti dello stack TICK in un unico eseguibile ed introducento un nuovo ampio insieme di funzionalita'
(eg. API v2, security, ...).
Le versioni di InfluxDB sono disponibili in linea su Git. Nel documento Your Server Stinks sono mantenute apposite sezioni aggiornate anche per InfluxDB.
(Sources: Official site Github )
| |
|
|
|
|
|
|
| 2 | Production | Whole TICK stack in a component, FLUX for everything. | 2.0.4 | 2020-11 | 2021-02 | |
| 1 | Production | (1.7 2018-11): Flux language support, Time Series Index (TSI), performance improvements
(1.8 2020-07): InfluxDB 2.0 API forward compatibility, Flux 0.65 | 1.8.4 | 2016-11 | 2021-02 | |
| 0 | EOL | High performance datastore for time series data. Single binary written in Go. Simple HTTP(S) APIs. Plugins support for data ingestion protocols: Graphite, collectd, and OpenTSDB. | 0.13 | 2013-10 | 2016-05 |
Gli upgrade sono molto semplici: basta spegnere il servizio, aggiornare il software e riavviare. Un poco piu' impegnativi possono essere i cambi di versione... ma per il passaggio alla 2.0 e' stato introdotto nella 1.8 la compatibilita' delle API.
Varie ed eventuali
InfluxDB e' supportato da moltissimi strumenti di interrogazione ed ha un ampio ecosistema.
Tra i molti anche Grafana fin dalle prime
versioni:
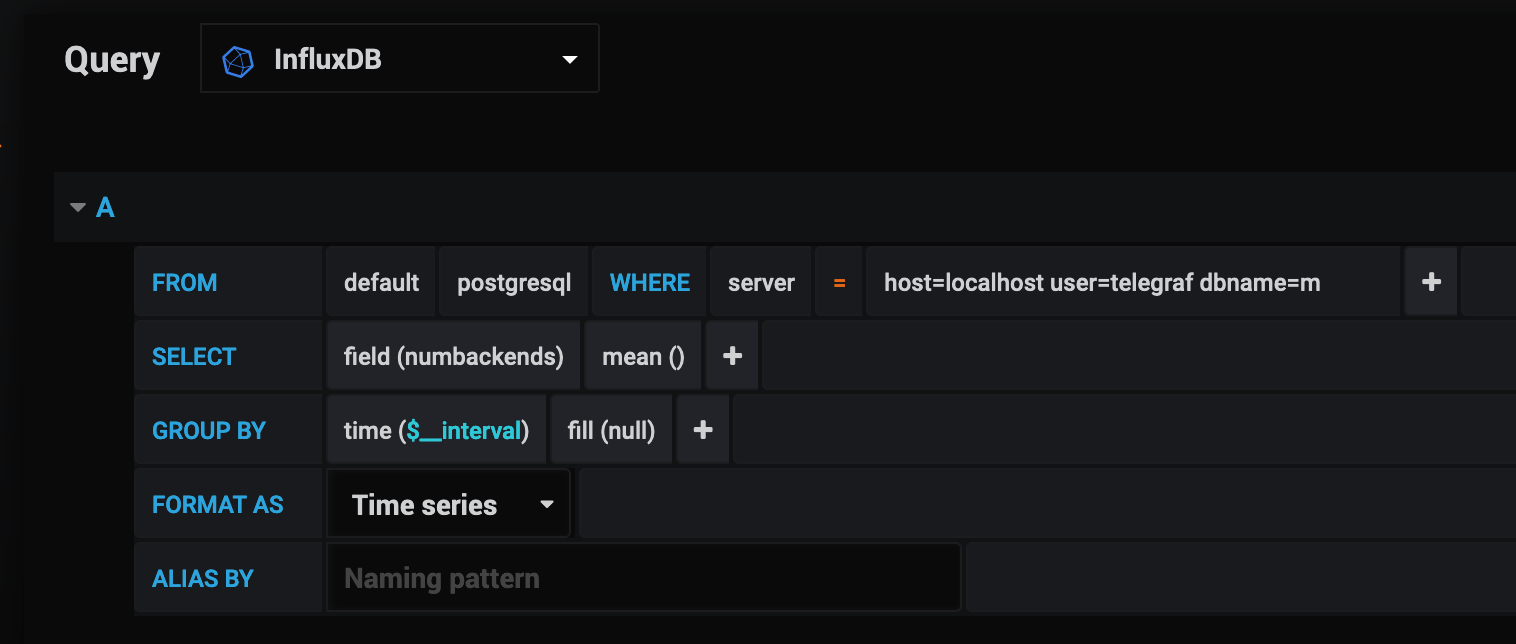
La versione community di InfluxDB opera su un server singolo mentre InfluxDB Enterprise puo' essere installata in cluster. E' anche disponibile il servizio InfluxDB Cloud AWS gestito da InfluxData (cfr. Sito ufficiale).
Titolo: Collezionare e visualizzare statistiche prestazionali dei database
Livello: Medio
Data:
31 Ottobre 2021
Versione: 1.0.1 - 14 Febbraio 2022 ❤️
Autore: mail [AT] meo.bogliolo.name